
Optimizar una célula solar orgánica suele ser un proceso lento y caro de ensayo y error: se fabrican muchos dispositivos, se mide cuál funciona mejor y se repite. En esta línea se enmarca el último trabajo del grupo de investigación Poli-Nano de la Universidad Miguel Hernández de Elche (UMH), publicado en la revista científica Scientific Reports bajo el título «Bridging predictive machine learning modeling with experimental fabrication of organic solar cells» (DOI: 10.1038/s41598-026-66984-2).
La investigación propone y valida un flujo de trabajo llamado «Predict-then-Verify» (predecir y luego verificar). Primero, modelos de aprendizaje automático seleccionan qué composiciones merece la pena fabricar. Después, esos dispositivos se fabrican y se miden durante 30 días para comprobar si las predicciones se cumplen. Aunque se trata de investigación básica sobre un sistema modelo, el estudio ofrece una evaluación realista de hasta dónde llegan hoy estas herramientas cuando salen del ordenador y entran en el laboratorio.
Figura 1. Ilustración conceptual del flujo «Predict-then-Verify»: modelos de aprendizaje automático seleccionan, entre miles de combinaciones posibles, las composiciones a fabricar; los dispositivos se fabrican, se miden durante 30 días y se comparan con las predicciones, y los resultados retroalimentan a los modelos. Imagen esquemática, no a escala.
El coste de probar y equivocarse
Las células solares orgánicas son ligeras, flexibles y se pueden fabricar a partir de disoluciones, lo que abre la puerta a su impresión a gran escala. Pero su rendimiento depende de muchas variables a la vez: la cantidad de cada material, la morfología de las capas o las condiciones ambientales durante la fabricación. Explorar ese espacio de parámetros a base de ensayo y error consume tiempo, energía y reactivos de alta pureza.
El aprendizaje automático ofrece una alternativa. Sin embargo, los autores señalan que muchos trabajos se quedan en el rendimiento computacional y no comprueban cómo se comportan los modelos frente a las fluctuaciones reales de un laboratorio. Este estudio intenta cerrar esa brecha.
Un flujo de trabajo en cinco pasos
El punto de partida son los modelos y la base de datos desarrollados previamente por el mismo grupo, que describen cómo evoluciona la eficiencia (PCE) de células ITO/PEDOT:PSS/P3HT:PCBM/Al con el tiempo. A partir de ellos, el flujo de trabajo sigue cinco etapas: modelos de partida, predicción de configuraciones no vistas, fabricación de los dispositivos propuestos, caracterización experimental junto con una segunda predicción que incorpora el tiempo meteorológico del día de fabricación, y verificación comparando lo medido con lo predicho. Los resultados vuelven después a la base de datos para reentrenar los modelos.
Se evaluaron cuatro algoritmos con el entorno ROBERT: gradient boosting (GB), random forest (RF), una red neuronal y un modelo lineal multivariante. Los dos últimos se descartaron: el modelo lineal daba eficiencias físicamente irreales (hasta casi el 15 %), y la red neuronal producía valores negativos y por encima del rango experimental conocido. El trabajo continuó con GB y RF, los dos algoritmos basados en árboles de decisión.
Dos dispositivos elegidos por el algoritmo
Los modelos exploraron miles de combinaciones de volumen de PEDOT:PSS (150–600 µL) y proporciones de P3HT y PCBM (0,7–1,6). Un resultado curioso fue que muchas combinaciones compartían la misma eficiencia máxima predicha. En particular, usar más PEDOT:PSS no mejoraba la predicción, de modo que el equipo eligió las configuraciones que menos material consumían, con 150 µL de PEDOT:PSS, frente a los 250–1000 µL del estudio previo.
Así se seleccionaron dos dispositivos, con proporciones P3HT:PCBM de 1,286 (Dispositivo 1) y 1,429 (Dispositivo 2). Ambos se fabricaron, se encapsularon y se midieron durante 30 días bajo iluminación AM1.5G, con una frecuencia de medida mayor que en el estudio original.
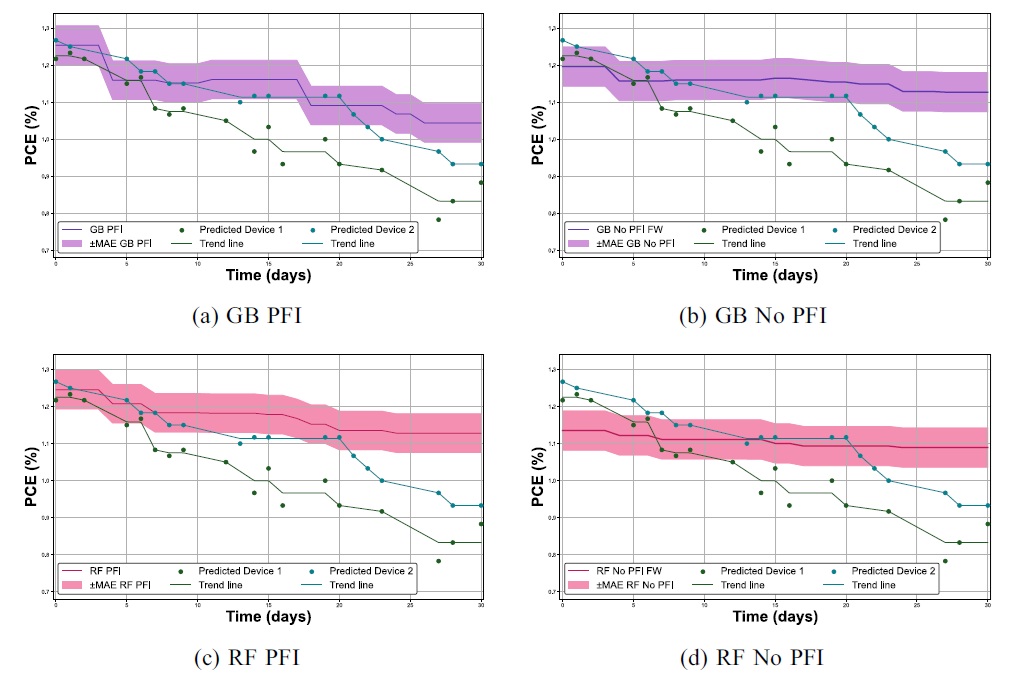
Figura 2. Representación esquemática de la evolución de la eficiencia (PCE) durante 30 días: predicción del modelo GB con su margen de incertidumbre (banda) y mediciones de los dos dispositivos fabricados. Esquema ilustrativo, no a escala.
Qué pasó durante 30 días
El primer día, los dispositivos confirmaron las predicciones: se midieron eficiencias del 1,22 % (Dispositivo 1) y del 1,27 % (Dispositivo 2), dentro del rango de 1,19–1,28 % que predecían los modelos. Ese es el principal resultado positivo del trabajo: los algoritmos supieron proponer composiciones con buen rendimiento inicial sin necesidad de explorar exhaustivamente. Con el paso del tiempo, la historia cambia. Los dispositivos se degradaron más rápido de lo previsto y llegaron al día 30 con eficiencias de 0,88 % y 0,93 %, frente al 1,04–1,19 % que predecían los modelos. El modelo GB que usa solo las variables más importantes (GB PFI) fue el más preciso: el Dispositivo 2 se mantuvo dentro del margen de error de la predicción hasta el día 23, y el Dispositivo 1, solo durante los primeros días. Los autores indican que el error relativo final de este modelo estuvo entre el 5,65 % y el 10,44 %. En cambio, el modelo RF PFI, que tenía el menor error durante el entrenamiento, acabó con desviaciones superiores al 24 % en el día 30.
El tiempo meteorológico también cuenta
Los modelos incluyen variables ambientales como temperatura, humedad, punto de rocío y presión, que el laboratorio no controla. Los investigadores compararon dos versiones del modelo: una con las condiciones meteorológicas del mejor experimento del estudio original y otra con las del día real de fabricación. Para el Dispositivo 2, el modelo GB sin selección de variables redujo su error medio de 0,104 a 0,083 al usar el tiempo del día de fabricación, y pasó de cinco predicciones fuera de rango a ninguna. El modelo RF también mejoró, de 0,088 a 0,075.
Modelos para acotar, no para clavar el óptimo
Los propios autores matizan el alcance del trabajo. Los algoritmos de árboles tienden a dar valores constantes para configuraciones parecidas, por lo que funcionan mejor como «proponedores de regiones» que como optimizadores exactos. Además, el estudio valida solo dos configuraciones, y las desviaciones aparecen en la fase inicial de estabilización de las células, para la que los datos de entrenamiento eran escasos. Entre los siguientes pasos, los autores proponen aumentar la frecuencia de las medidas en las primeras semanas y reintroducir en los modelos puntos experimentales de verificación en los bordes de las zonas donde las predicciones se estancan.
Un paso hacia el diseño guiado por datos
Este trabajo demuestra que los modelos de aprendizaje automático pueden reducir de forma notable el espacio que hay que explorar en el laboratorio, aunque todavía no sustituyen a la experimentación. Todos los datos, los scripts y los informes del trabajo están disponibles de forma abierta en el repositorio de GitHub del grupo, de modo que otros equipos puedan reproducirlo y aplicarlo a nuevos materiales.